LEARNING NOTE
从一个标量开始理解自动求导
从 y = x² 的计算图出发,把 requires_grad、backward 和梯度累积放到同一个例子里。
这是一份基础学习示例,使用可以手算验证的数值解释自动求导,不包含任何模型训练的实测结果。
从手算导数开始
设一个最简单的计算:
当 时,,梯度为 。这里的梯度描述的是输入在当前点附近发生微小变化时,输出如何变化。
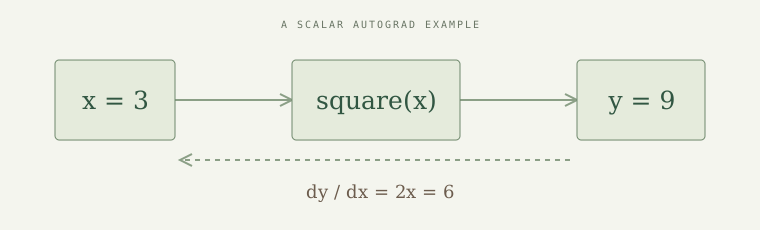
让 PyTorch 记录计算过程
import torch

x = torch.tensor(3.0, requires_grad=True)
y = x.square()
y.backward()

assert torch.isclose(y.detach(), torch.tensor(9.0))
assert x.grad is not None
assert torch.isclose(x.grad, torch.tensor(6.0))
requires_grad=True 表示需要跟踪这个张量参与的可微计算。backward() 沿着计算图反向传播,叶子张量的梯度会写入 .grad。
这里的 y 是标量,所以可以直接调用 backward()。如果输出有多个元素,需要先聚合成标量,或提供与输出形状相容的上游梯度。
梯度为什么会累积
对同一个叶子张量做两次独立计算,梯度会相加:
x = torch.tensor(3.0, requires_grad=True)
x.square().backward()
x.square().backward()  # 新建第二张计算图

assert x.grad is not None
assert torch.isclose(x.grad, torch.tensor(12.0))

x.grad = None
x.square().backward()
assert torch.isclose(x.grad, torch.tensor(6.0))
这就是训练循环里需要管理梯度清零的原因之一。常见做法是每个更新步骤调用 optimizer.zero_grad(set_to_none=True);如果有意做梯度累积,则需要按所设计的更新频率处理。
从单步求导走向训练循环
学习训练流程时,可以先按这条链路理解:前向计算得到预测值,损失函数把误差化成标量,反向传播计算梯度,优化器更新参数。
这个式子对应最基础的梯度下降。它不意味着任意学习率都能收敛,也不能替代对数据、目标函数和评估方法的检查。
留给下一次练习的问题
- 向量输入时,梯度形状与输入是什么关系?
detach()与torch.no_grad()各适用于什么情况?- 为什么训练损失下降,还需要独立的验证和测试?